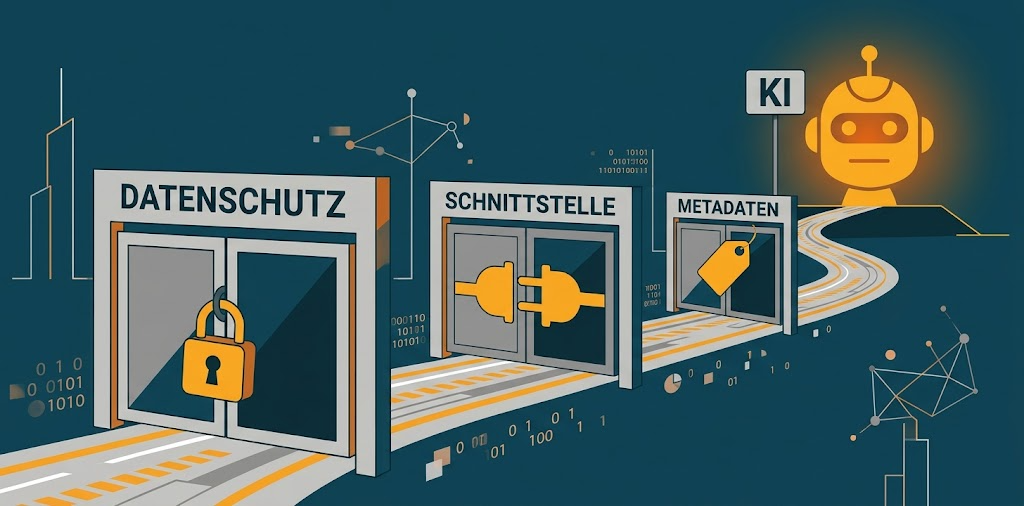
Fast jedes Unternehmen will seine Unternehmensdaten mit KI nutzen. Die Kundendaten liegen im CRM, Aufträge und Rechnungen im ERP, und statt sich Informationen jedes Mal zusammenzusuchen, soll die KI darauf zugreifen. Dann genügt eine Frage wie „Welche Kunden haben in den letzten sechs Monaten weniger bestellt?“ oder „Welche Aufträge sind noch offen?“, und die Antwort kommt direkt. In Projekten stoßen wir dabei immer auf dieselben drei Hürden: den Datenschutz, die Schnittstellen und die Metadaten. Die KI selbst ist selten das Problem.
Hürde 1: Dürfen die Daten überhaupt an eine KI?
Die erste Frage kommt meist schon im ersten Gespräch: Dürfen wir unsere Daten an eine KI geben? Die Antwort lautet je nach Daten und Aufbau unterschiedlich. Kundendaten, Personaldaten und Geschäftszahlen unterliegen verschiedenen Anforderungen, und es kommt darauf an, wo das System läuft und wohin Daten bei einer Abfrage gelangen. Man kann sie nicht einfach irgendwohin schicken.
Für den Einstieg hilft eine kurze Bestandsaufnahme. Welche Datenarten sollen genutzt werden? Gehört dazu etwas, das nur das Unternehmen selbst sehen darf? Soll das System im eigenen Haus laufen oder bei einem Anbieter, und wer darf welche Daten abfragen? Wer diese Fragen früh mit der Datenschutzverantwortung klärt, vermeidet, dass ein fertiges Vorhaben im letzten Schritt gestoppt wird.
Hürde 2: Kommen wir überhaupt an die Daten?
Selbst wenn der Datenschutz geklärt ist, bleibt die zweite Hürde. Die Daten liegen in CRM, ERP oder einem anderen geschlossenen System, oft ohne passende Schnittstelle oder vernünftigen Zugriff. Dann kann die KI nicht sinnvoll damit arbeiten, egal wie gut sie ist. Das erklärt, warum viele Unternehmen mit einzelnen Dokumenten und manuellen Eingaben arbeiten, obwohl die eigentlichen Informationen längst im System liegen.
Je nach System gibt es drei Wege, und jeder ist vorab zu prüfen: ob der Hersteller eine Schnittstelle anbietet, ob lesender Zugriff auf die Datenbank erlaubt und technisch möglich ist, oder ob ein regelmäßiger Export in einen separaten Datenbestand genügt. Entscheidend ist die Reihenfolge. Zuerst klären, ob und wie der Zugriff geht, dann erst über KI sprechen. Dazu passt die Empfehlung aus KI größer denken: Vor der Umsetzung prüfen, welche Daten nötig sind und in welchem Zustand sie vorliegen, denn dort scheitern die meisten Vorhaben, nicht am Modell.
Hürde 3: Die KI versteht die Felder nicht
Die dritte Hürde ist die aufwendigste und wird am häufigsten unterschätzt. Eine Datenbank ist voll mit Feldern wie ARTNR_ALT, VKPREIS2 oder STATUS_KZ. Damit eine KI eine Frage wie „Zeige mir die Top 10 Kunden nach Umsatz pro Artikelkategorie“ sauber in eine Datenbankabfrage übersetzen kann, muss sie das Datenmodell verstehen. Was bedeutet welches Feld? Welche Werte sind erlaubt? Welche Einschränkungen und Besonderheiten gibt es?
Diese Beschreibungen heißen Metadaten. Bisher musste ein Fachexperte sie von Hand pflegen, Feld für Feld. Beim Aufbau einer Datenbank-KI war das der mit Abstand aufwendigste Schritt, teurer als die KI selbst. Wie sehr die Qualität dieser Beschreibungen die Ergebnisse bestimmt, zeigt auch Self-Service-Datenanalyse, das den Nutzen für Fachabteilungen beschreibt.
Zwei Abkürzungen für die Metadaten
Inzwischen gibt es zwei Wege, den Aufwand zu senken.
Erstens kann die KI aus den Daten selbst lernen. Wenn der Datenschutz es zulässt, bekommt sie einen Ausschnitt echter Datensätze und leitet daraus Wertelisten, Formate und Bedeutungen ab. In einem ersten Pilotprojekt hat sich die KI so Zusammenhänge selbst erschlossen, für die sonst Workshops und viel Zeit nötig gewesen wären. Der Weg hängt allerdings wieder an der ersten Hürde: Echte Datensätze zu verwenden setzt voraus, dass die Datenschutzfrage geklärt ist.
Zweitens kann die KI den Quellcode lesen. Bei Bestandssystemen liegt der komplette Quellcode häufig vor, und daraus lässt sich herleiten, was die Felder bedeuten: Welches kryptische Datenbankfeld heißt in der Oberfläche eigentlich wie, und welche Einheiten, Umrechnungen und Formeln stecken dahinter? Dieses Wissen tragen sonst nur langjährige Mitarbeiter im Kopf. Die Überlegung dahinter ist plausibel: Der Code weiß, was die Datenbank verschweigt.
In beiden Fällen prüft am Ende ein Fachexperte das Ergebnis. Prüfen geht deutlich schneller, als alles von Null aufzubauen. Das Ergebnis sind weniger Workshops, weniger Konfiguration von Hand und ein schnellerer Start.
Unternehmensdaten mit KI nutzen: die Reihenfolge der drei Hürden
Eine sinnvolle Reihenfolge lässt sich festhalten:
- Datenschutz klären: welche Daten, welcher Betrieb, welche Zugriffsrechte.
- Zugriff klären: Schnittstelle, lesender Datenbankzugriff oder Export, jeweils mit dem Hersteller des Systems abgestimmt.
- Metadaten aufbauen: aus Beispieldaten, aus dem Quellcode oder, wo beides nicht geht, mit Fachexperten, und immer mit einer fachlichen Prüfung.
Wer eine eigene Lösung erwägt, findet im Beitrag Eigene KI bauen? Build, Buy oder Wait die Fragen, die davor zu klären sind.
Fazit
Unternehmensdaten mit KI nutzen scheitert in der Praxis selten am Modell, sondern am Datenschutz, am Zugriff auf geschlossene Systeme und an unverständlichen Datenbankfeldern. Die ersten beiden Punkte sollten vor jedem Projektstart geklärt sein. Bei den Metadaten lässt sich der größte Aufwand inzwischen verkürzen, weil KI Bedeutungen aus Beispieldaten und Quellcode ableiten kann und der Fachexperte nur noch prüft.